Transparenzhinweis: Dieser Beitrag ist redaktionell unabhängig verfasst. Es handelt sich um keine bezahlte Werbung oder Kooperation mit Anthropic oder verbundenen Plattformen.
Anthropic hat am 29. September 2026 mit der Veröffentlichung von Claude Sonnet 5.5 die Messlatte für moderne KI-Modelle erneut nach oben verschoben. Während der direkte Vorgänger Claude Sonnet 5 erst im Sommer 2026 an den Start ging, schlägt das Update auf Version 5.5 in Entwickler- und Tech-Communities bereits wie eine Bombe ein.
Das Modell haut in Praxistests und Labor-Setups schlichtweg vom Hocker / haut einen schlichtweg um: Es ist nicht nur messbar intelligenter, sondern arbeitet vor allem drastisch schneller, zielgerichteter und mit deutlich weniger Wiederholungsschleifen als Sonnet 5. Bleib deshalb dran, um zu erfahren, weshalb Claude Sonnet 5.5 ein Biest ist!
Der Generationssprung: Warum Sonnet 5.5 vieles verändert
Claude Sonnet 5 war ein solider Allrounder für Standard-Workflows und Code-Aufgaben. Sonnet 5.5 hingegen wurde gezielt für agentische Aufgaben, tiefes Codebase-Verständnis und autonome Workflows optimiert.
Auffällig ist vor allem das Verhalten bei komplexen Problemen:
- Weniger Fehlversuche: Wo Sonnet 5 noch häufiger in Websuchen oder redundante Shell-Aufrufe abdriftete, arbeitet Version 5.5 in komprimierten, präzisen Zügen.
- Multimodale Dominanz: Die visuelle Analyse von Dokumenten, Dashboards und Interfaces erreicht ein völlig neues Niveau.
- Drastische Latenzreduktion: Antworten starten schneller und generieren Text mit spürbar höherem Token-Durchsatz.
Benchmarks & Referenzwerte: Sonnet 5.5 vs. Sonnet 5
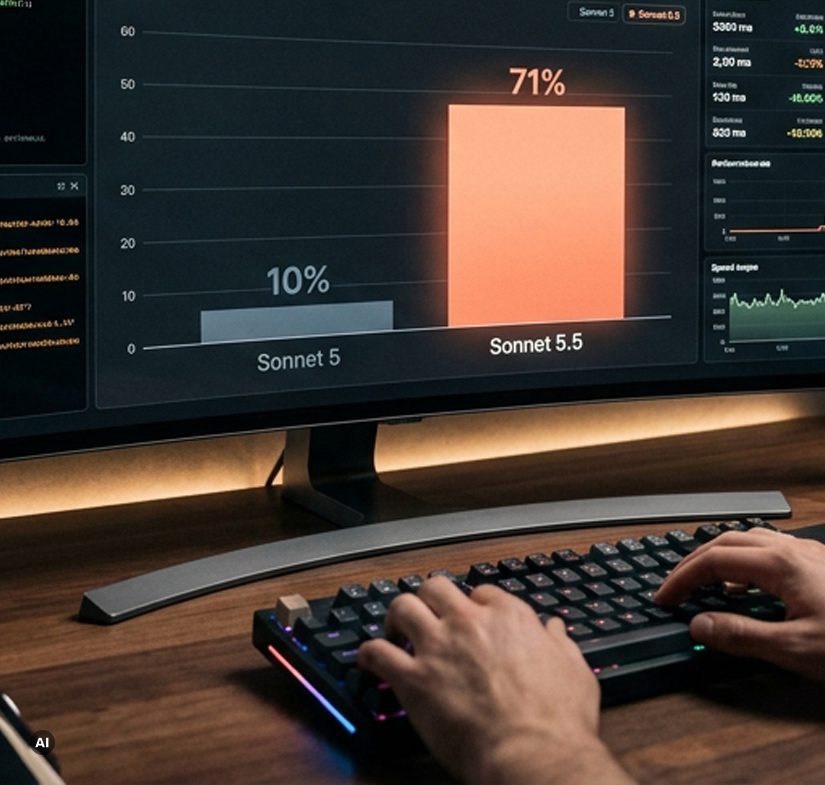
Die offiziellen Leistungs- und Performancedaten verdeutlichen den Unterschied zwischen den beiden Modell-Generationen:
| Metrik / Benchmark | Claude Sonnet 5 | Claude Sonnet 5.5 | Leistungsdifferenz |
| Terminal-Bench 4.0 (Agentic Coding) | 10,3 % | 70,6 % | +60,3 Prozentpunkte |
| Chartography (Visuelle Diagramme/UI) | 15,6 % | 61,6 % – 64,4 % | Vervierfachung der Genauigkeit |
| CursorBench 4.0 (IDE-Assistent) | ~38,2 % | 55,5 % | Deutlicher Sprung auf Opus-Niveau |
| Reine Generierungs-geschwindigkeit | Basiswert (~60–70 T/s) | 30 %+ schneller | Spürbar geringere Latenz |
| Praxis-Workflow-Speed (z. B. Source-Checking) | Basis | Bis zu 2,4x schneller | Massive Zeitersparnis bei Long-Horizon-Tasks |
| Tool-Calls pro Entwickler-Task | 100 % (Basis) | ~33 % weniger Aufrufe | Effizientere Befehlsketten |
| Shell-Runs bis zum Task-Abschluss | 100 % (Basis) | ~50 % weniger Ausführungen | Halbierte Debugging-Schleifen |
| API-Preis pro 1M Tokens | $2 Input / $10 Output | $2 Input / $10 Output | Identischer Nominalpreis |
| Effektive Kosten pro Task | 100 % (Basis) | Bis zu 30 % günstiger | Weniger Tokenverbrauch für dasselbe Ergebnis |
Geschwindigkeit in der Praxis: Keine leeren Marketing-Versprechen
Ein theoretischer Benchmark ist gut, aber der reale Durchsatz entscheidet über den Alltagseinsatz. Anthropic gibt die reine Ausgabegeschwindigkeit mit über 30 % Zuwachs gegenüber Sonnet 5 an.
In realen Software-Entwicklungsumgebungen (beispielsweise Claude Code, Cursor oder agentischen Pipelines) fällt der Vorteil noch dramatischer aus:
- Direktere Lösungswege: Weil Sonnet 5.5 Aufgaben robuster strukturiert, benötigt es rund ein Drittel weniger Werkzeug- und API-Aufrufe.
- Kompaktere Ausgaben: Anstelle ausschweifender Erklärungen vor der Code-Generierung liefert das Modell direkt ausführbare Patches.
- Selbstkorrektur vor Ausführung: Fehler in Codebasen werden bereits im Token-Stream erkannt und behoben, anstatt erst nach fehlschlagenden Terminal-Tests.
Für Entwickler und Unternehmen halbiert sich dadurch in vielen komplexen Szenarien die effektive Wartezeit bis zum fertigen Ergebnis.
Kosteneffizienz: Gleicher Preis, aber deutlich billiger
Obwohl Anthropic die Token-Preise auf API-Ebene bei 2 $ pro Million Input-Tokens und 10 $ pro Million Output-Tokens belässt (mit Prompt-Caching ab 0,20 $), sinken die tatsächlichen Gesamtrechnungen.
Da Sonnet 5.5 pro Problemlösung deutlich weniger Denk- und Zwischenschritte generiert, sinken die effektiven Task-Kosten um bis zu 30 Prozent. Auf mittleren Effort-Stufen schlägt das Modell oft sogar die Maximalleistungen des alten Sonnet 5 und das zu einem Bruchteil der damaligen Rechenleistung.
Das Urteil
Claude Sonnet 5.5 macht seinem Ruf alle Ehre: Es schließt die Lücke zu teureren Flaggschiff-Modellen wie Claude Opus 5.5 und lässt Sonnet 5 in puncto Agentic Coding, visueller Auffassungsgabe und Arbeitsgeschwindigkeit weit hinter sich. Wer im Entwickler- oder KI-Agenten-Bereich auf schnelle, präzise und kosteneffiziente Ergebnisse angewiesen ist, hat ab sofort einen neuen Standard.
Hat dir dieser Beitrag etwas gebracht?
Dann teile ihn mit jemandem, dem er genauso helfen könnte, guter Content verdient es, gesehen zu werden.
Was beschäftigt dich gerade? Schreib uns deine Meinung in die Kommentare. Wir lesen jeden Kommentar und versuchen alle zu beantworten.
Wenn du tiefer einsteigen willst, schau dir unsere Arbeit an, stöbere durch unser FAQ oder meld dich direkt bei uns. Wir freuen uns auf einen Austausch.
Kein Beitrag verpassen? Folge uns auf Social Media, dort teilen wir kurze Insights, Gedanken und alles was uns gerade bewegt: